戻る

検索結果

      ホーム / Uncategorized / Data Analysis 3.0:クラスタを検出し、より速く学習し、関係性をより明確に把握

      Data Analysis 3.0:クラスタ認識、高速トレーニング、関係性をより明確に表示

      SCALE.sdmアドオンのData Analysisは、試験データの傾向を可視化し、異常値を検出し、メタモデルの作成を支援します。バージョン3.0では、自動クラスタ解析、グラフィックカードでのトレーニング、大幅に強化されたパラレルコーディネーツプロット、そしてよりスムーズな分析開始が新たに加わりました。

      バージョン3.0により、Data Analysisはシミュレーションおよび試験データから迅速に信頼できる知見を得るための、SCALE.sdm内でさらに強力なツールとなります。

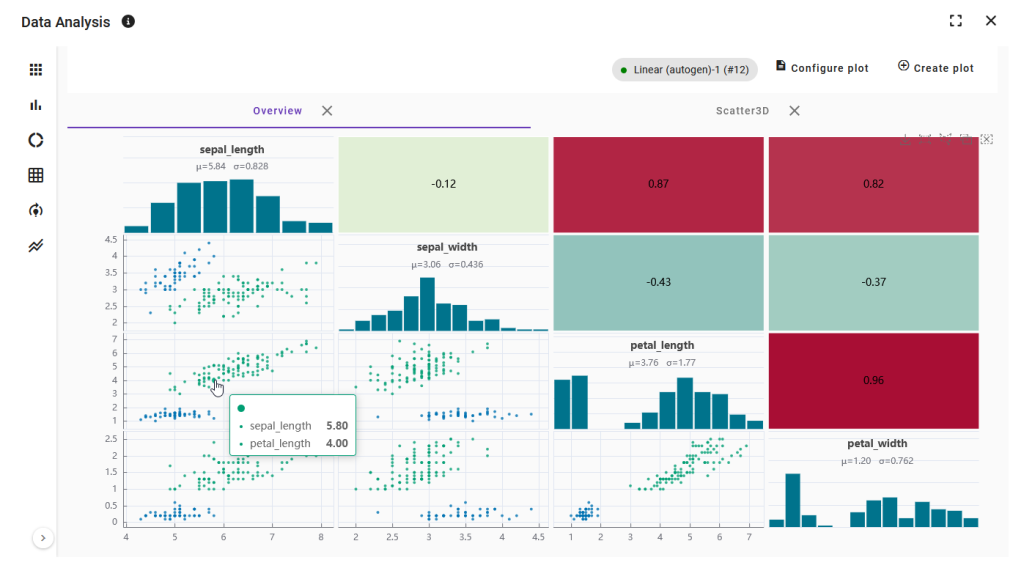
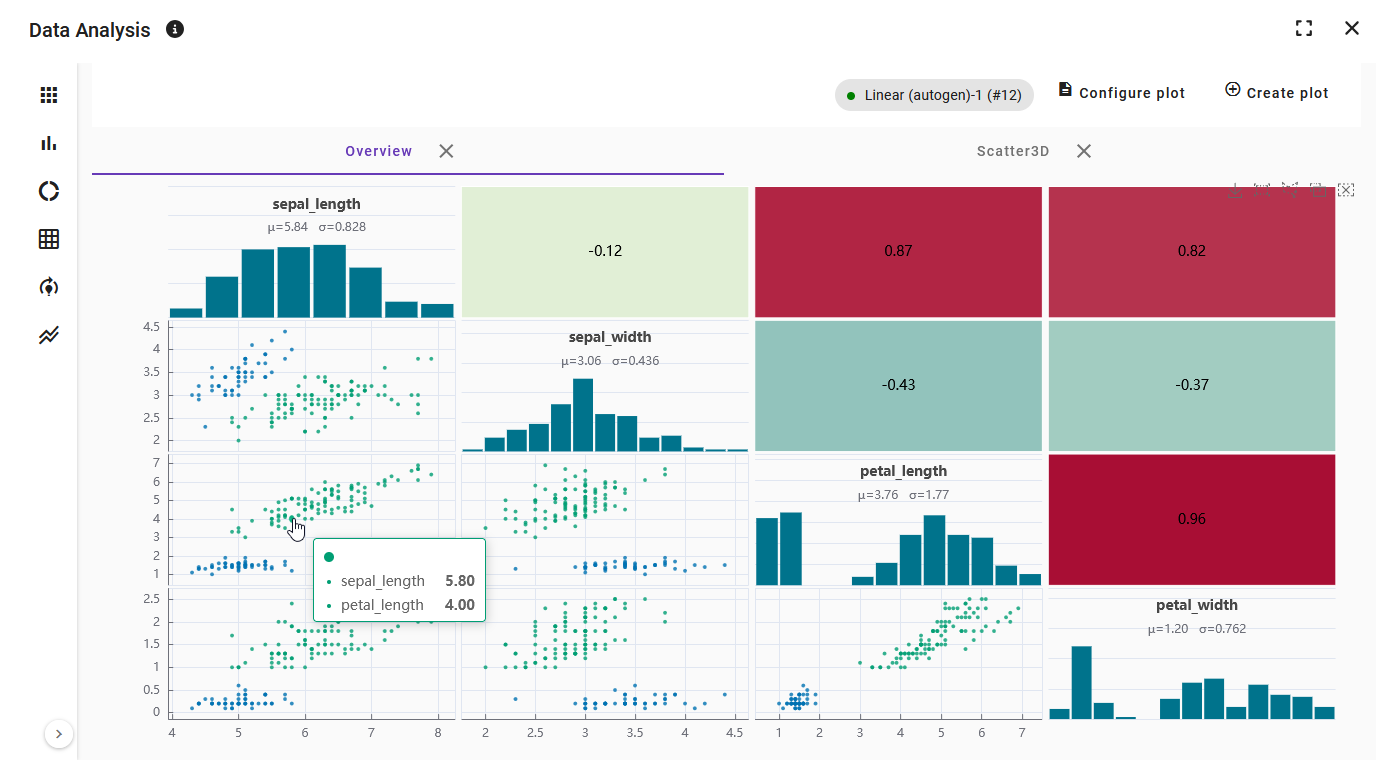
      Übersichtsmatrix mit Histogrammen, Streudiagrammen und Korrelationen
      Die Übersichtsmatrix kombiniert Histogramme, Streudiagramme und Korrelationen.
      類似したテストを自動でグルーピング

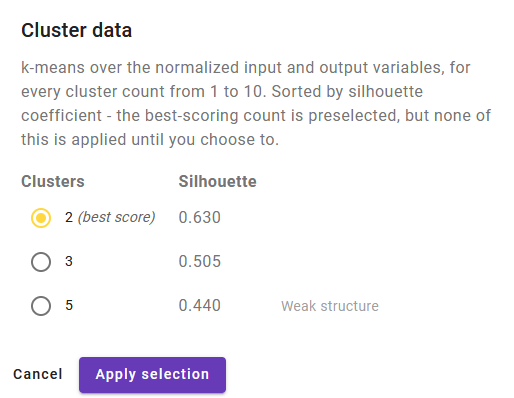
      新しいクラスタ解析は、類似した入力および出力の特性を持つテストをグループにまとめます。これにより、単一のプロットでは見えなかったデータのパターンを発見できます。

      このアドオンはk-Meansアルゴリズムを利用し、最適なクラスタ数を算出します。結果はさらに評価されます。

      適用後、各テストはデータテーブルにクラスタ列が追加されます。各クラスタには固有の色が割り当てられ、色はカスタマイズ可能です。クラスタの表示・非表示はすべてのプロットまたは特定のプロットで切り替えられます。

      Dialog „Cluster data“ mit Silhouetten-Score je Clusteranzahl
      Jede Clusteranzahl wird bewertet, die beste ist vorausgewählt.
      「Color plots by」で一括カラー設定

      現在は単一の設定で、すべてのプロットがどのように着色されるか(異常値ステータス別、ラベル別、またはクラスタ別)を決定できます。これにより、すべての表示がひと目で一貫性を持ちます。この新しい設定は、従来プロット毎に個別に設定していた選択肢を置き換えます。

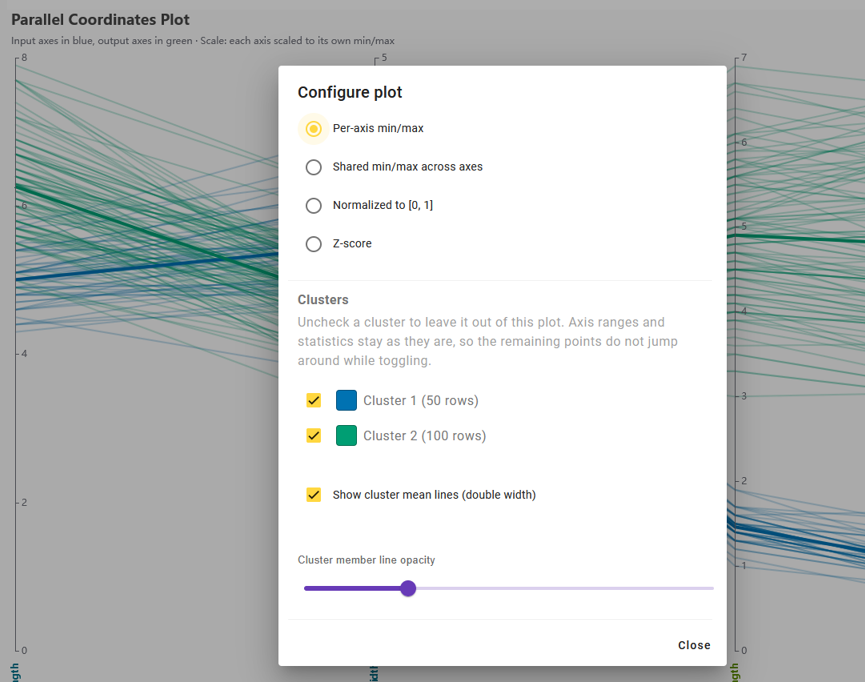
      Konfiguration des Parallel Coordinates Plot mit Clustern, Mittelwertlinien und Transparenz
      Achsenskalierung, Cluster-Auswahl, Mittelwertlinien und Transparenz in einem Dialog.
      パラレルコーディネーツプロット:関係性を一目で把握

      パラレルコーディネートプロットは、入力または出力として設定された変数から直接軸を取得するようになりました。

      • 4つの軸スケーリング:各軸ごと、共通の値範囲、[0, 1]に正規化、またはzスコアとして。
      • クラスタリングされたデータでは、プロットが各クラスターの平均値を強調表示された線で示します。
      • 個々の線はフェードアウトされ、平均値が前面に強調されます。透明度はスライダーで調整可能です。

      GPUでのトレーニングでメタモデルを高速化

      ニューラルネットワークを使ったメタモデルは、ブラウザが対応していればグラフィックカード(GPU)でトレーニングされます。このオプションはデフォルトで有効になっており、次回のセッションにも保存されます。設定は不要で、グラフィックカードが利用できない場合は自動的にプロセッサ上でトレーニングが続行されます。モデルはどちらの場合も同一で、トレーニング時間のみが異なります。

      ニューラルネットワークのデフォルト設定もアドオンで使用される典型的なデータセットに合わせて調整されました。トレーニングは最大800エポックまで行われますが、モデルの改善が見られなくなった時点で停止します。

      一目でわかるモデルの品質

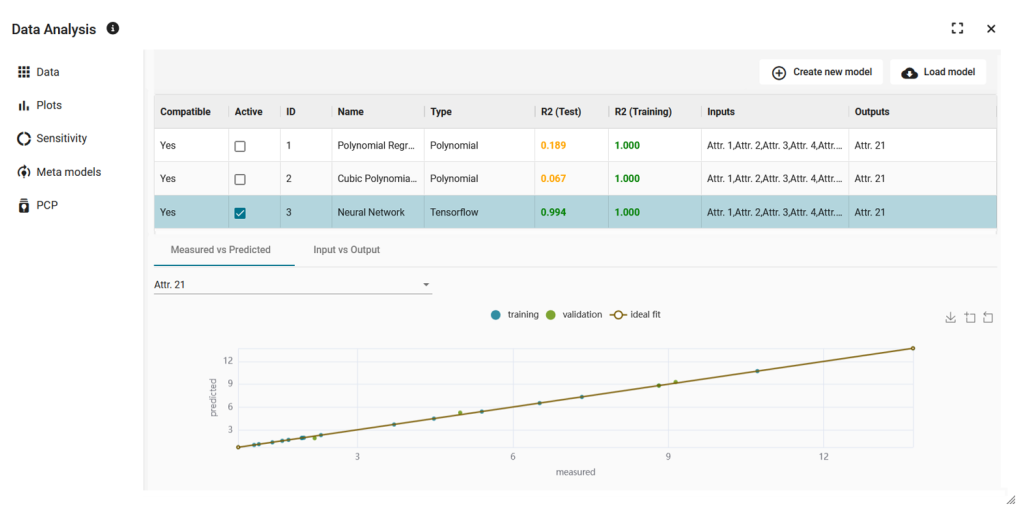
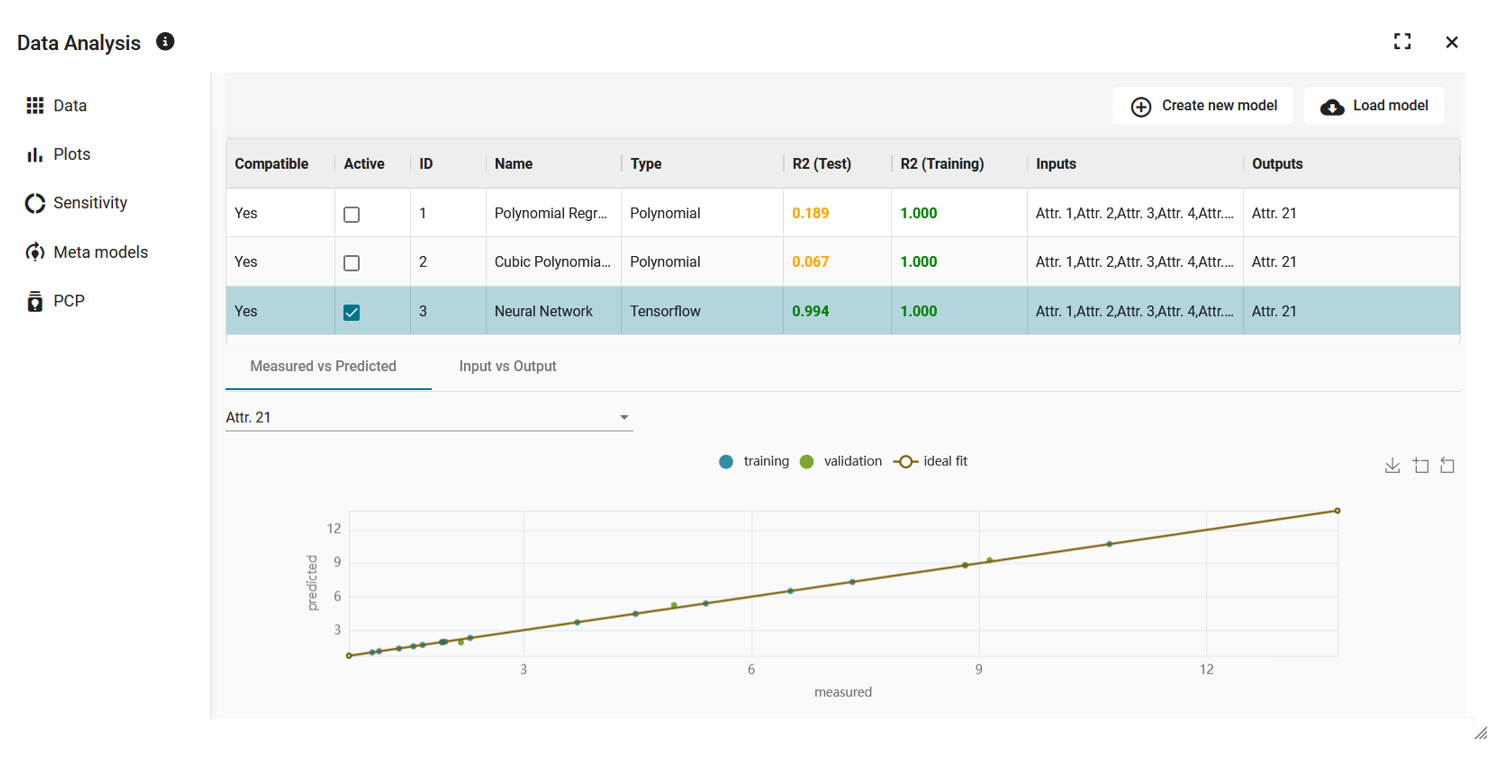
      各モデルに対して、テストとトレーニングの値をまとめたカラーバリューが割り当てられます。これはモデル一覧やプロットのモデル選択、感度分析で表示されます。モデルのテストまたはトレーニングデータでの結果が単純な平均値予測より悪い場合、評価は常に赤色になります。良好なトレーニング結果が未知のデータでの失敗を隠すことはありません。

      分析への迅速な導入

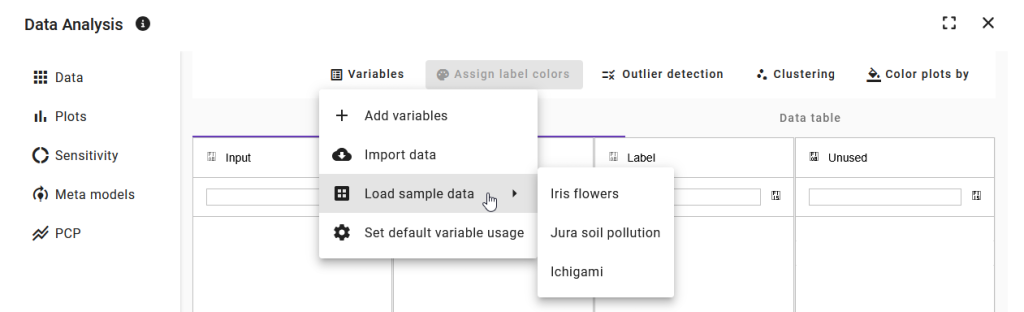
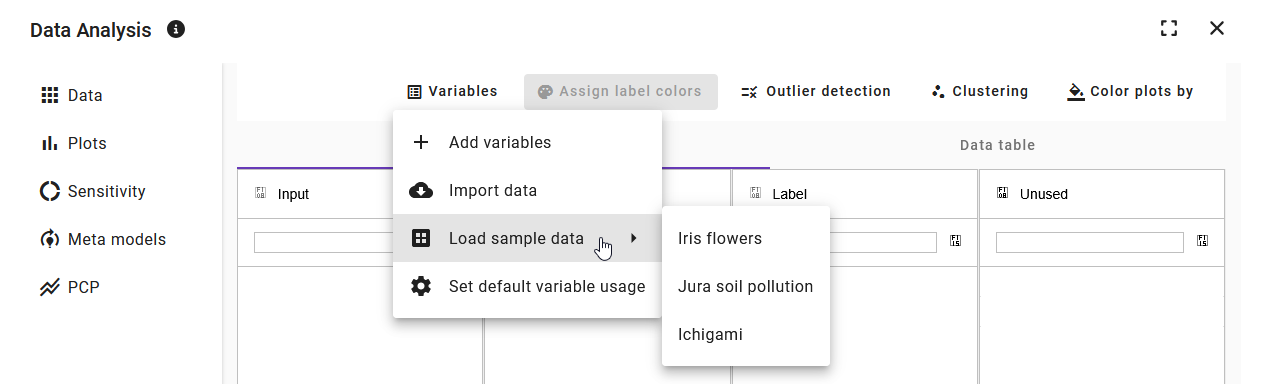
      最初の印象をつかむために、3つのサンプルデータセットが用意されています:クラスタリングの第一歩として定番のアイリスデータセット、複数の出力変数を持つ土壌汚染のデータセット、そして入力と出力がすでに対応付けられている合成データセットです。

      その他の新機能

      • CSVファイルはアドオンのテストの添付ファイル領域から直接開けるようになりました。
      • 新しく開いたデータセットは、ヒストグラム、散布図、相関行列の概観マトリックスと3D散布図から始まります。必要に応じてさらに多くのプロットが追加されます。
      • 外れ値検出は「すべてのテストを再アクティブ化する」と「外れ値マークを削除する」を区別するようになりました。
      • パネルバーは細いアイコンバーに折りたたむことができ、解析スペースを広く取れるようになりました。