Inicio / Uncategorized / Data Analysis 3.0: Reconocer clusters, entrenar más rápido, ver relaciones con mayor claridad
Publicado el
Data Analysis 3.0: Detecta clústeres, entrena más rápido, ve relaciones más claras
El complemento SCALE.sdm Data Analysis ayuda a visualizar tendencias en datos experimentales, detectar valores atípicos y crear metamodelos. Con la versión 3.0 llegan numerosas novedades: un análisis de clústeres automático, entrenamiento en la tarjeta gráfica, un Parallel Coordinates Plot mucho más ampliado y un acceso más rápido al análisis.
Con la versión 3.0, Data Analysis se convierte en una herramienta aún más potente para obtener rápidamente conocimientos sólidos de datos de simulación y experimentales, directamente en SCALE.sdm.
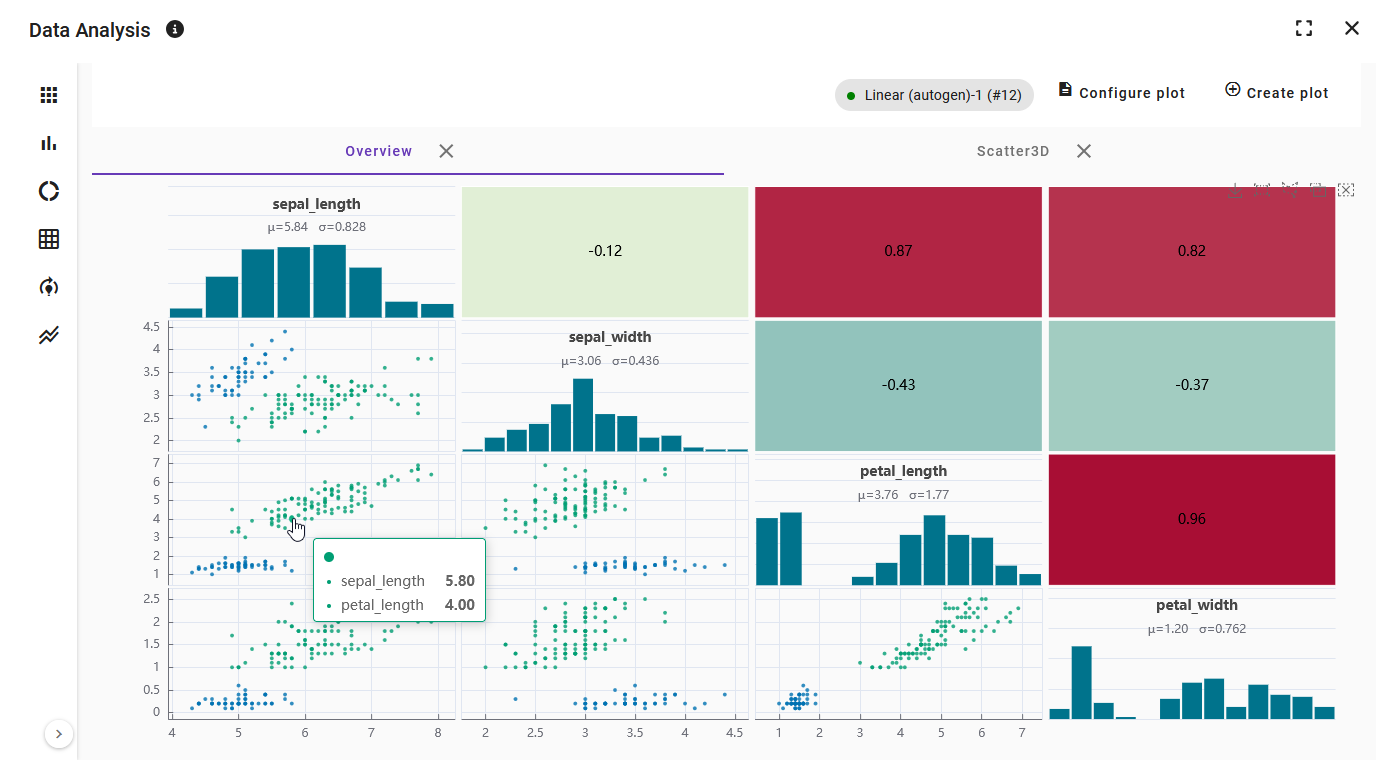
Die Übersichtsmatrix kombiniert Histogramme, Streudiagramme und Korrelationen.
Agrupar automáticamente pruebas similares
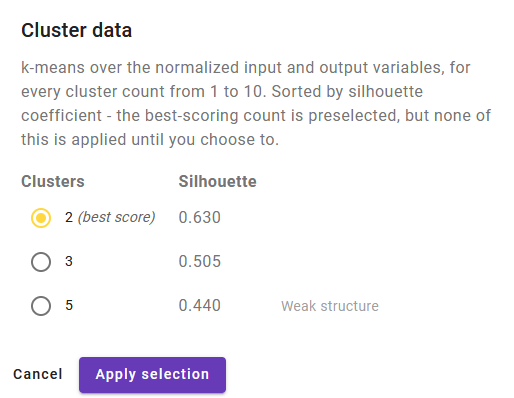
El nuevo análisis de clústeres agrupa pruebas con tamaños de entrada y salida similares. Así se pueden descubrir patrones en los datos que no son visibles en un solo gráfico.
El complemento utiliza para ello el algoritmo k-Means y determina el número óptimo de clústeres. Además, los resultados se evalúan.
Después de aplicar, cada prueba recibe una columna de clúster en la tabla de datos. Cada clúster obtiene un color propio que se puede ajustar, y puede mostrarse u ocultarse en todos los gráficos o selectivamente en gráficos individuales.
Jede Clusteranzahl wird bewertet, die beste ist vorausgewählt.
Colorear uniformemente con “Color plots by”
Una única configuración ahora determina cómo se colorean todos los gráficos: según el estado de valor atípico, la etiqueta o el clúster. Así, todas las visualizaciones son coherentes de un vistazo. La nueva configuración reemplaza la selección anterior que se tenía que ajustar individualmente en cada gráfico.
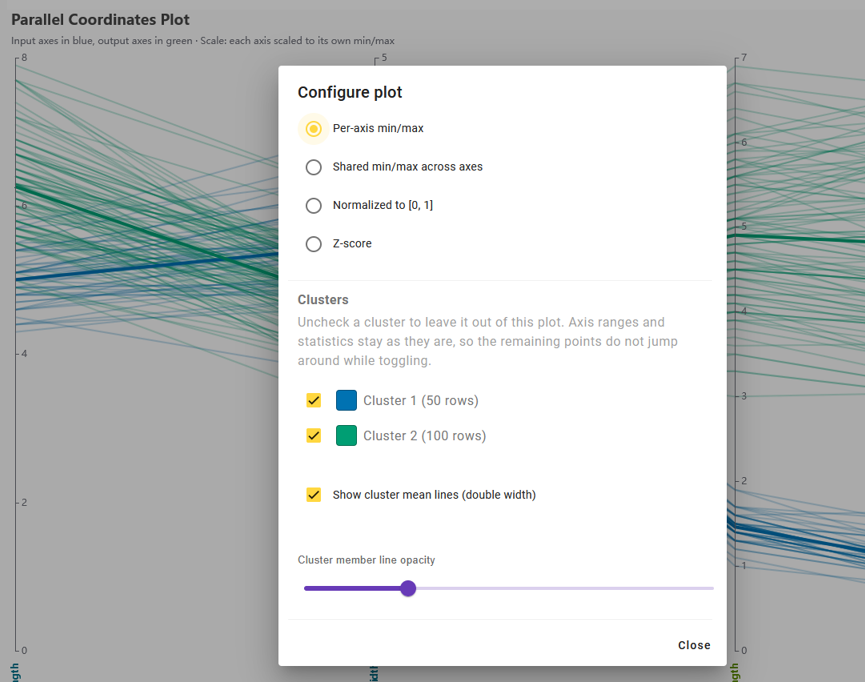
Achsenskalierung, Cluster-Auswahl, Mittelwertlinien und Transparenz in einem Dialog.
Parallel Coordinates Plot: relaciones de un vistazo
El Diagrama de Coordenadas Paralelas toma ahora sus ejes directamente de las variables establecidas como entrada o salida.
Cuatro escalas de eje: por eje, rango común de valores, normalizado a [0, 1] o como puntuación z.
Para datos agrupados, el diagrama muestra el valor medio de cada clúster como una línea resaltada.
Las líneas individuales se atenúan para que los valores medios estén en primer plano. La transparencia puede ajustarse mediante un deslizador.
Más rápido hacia el metamodelo: entrenamiento en GPU
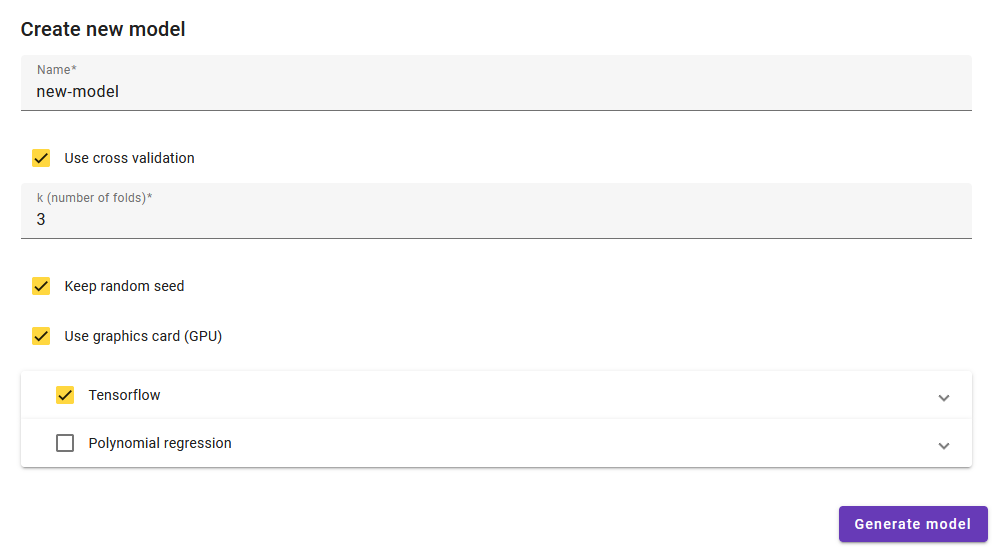
Los metamodelos con redes neuronales ahora se entrenan en la tarjeta gráfica (GPU), siempre que el navegador lo soporte. La opción está activada por defecto y se guarda para la siguiente sesión. No se requiere configuración: si no hay tarjeta gráfica disponible, el entrenamiento continúa automáticamente en el procesador. El modelo es idéntico en ambos casos, solo difiere la duración del entrenamiento.
También se han ajustado las configuraciones predeterminadas para redes neuronales a los conjuntos de datos típicos del complemento. Un entrenamiento ahora puede durar hasta 800 épocas, pero se detiene en cuanto el modelo deja de mejorar.
Calidad del modelo de un vistazo
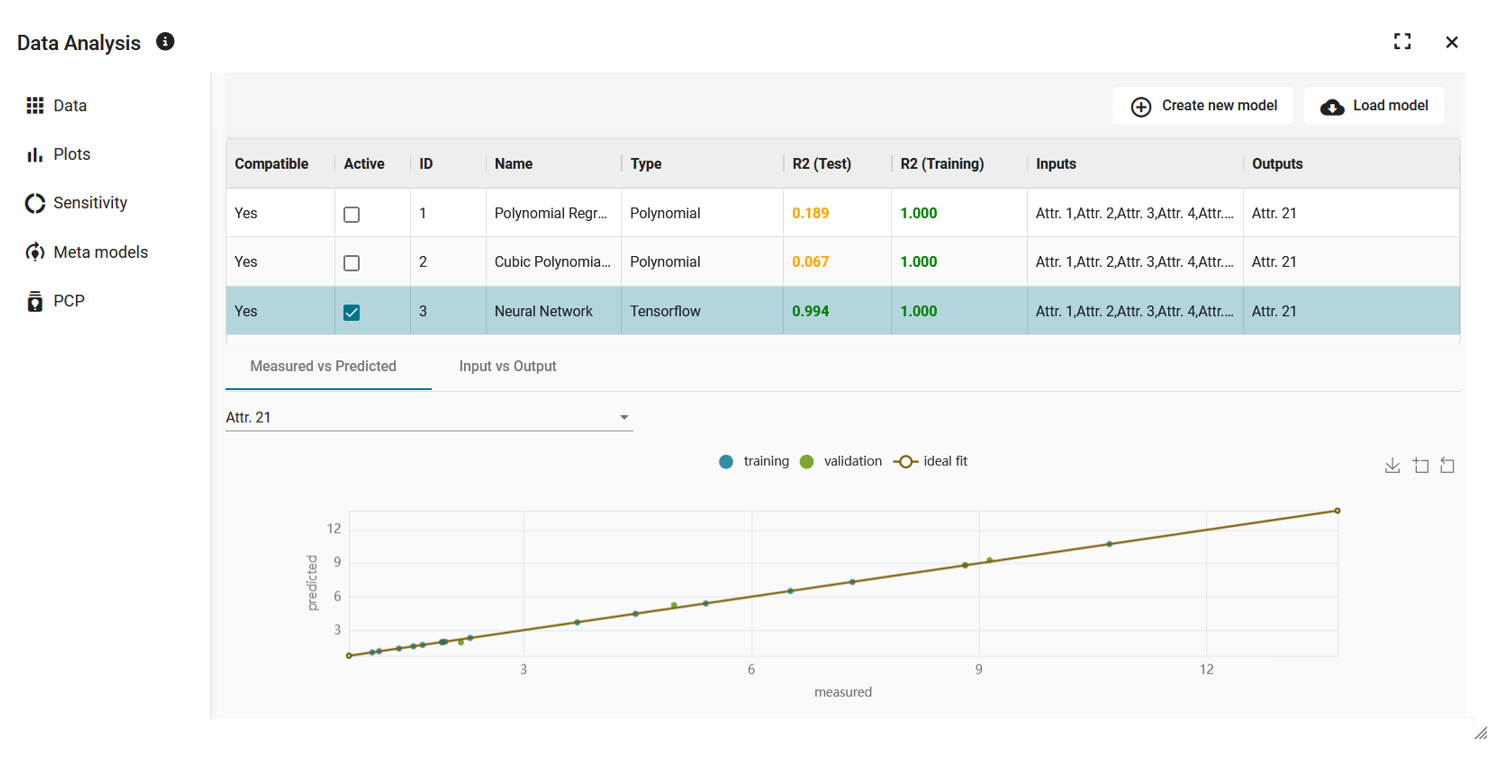
Cada modelo recibe una evaluación en color que resume los valores de prueba y entrenamiento. Aparece en la lista de modelos y en la selección de modelos de los gráficos y análisis de sensibilidad. Si un modelo rinde peor en datos de prueba o entrenamiento que una simple predicción del promedio, la evaluación es siempre roja. Un buen valor de entrenamiento no puede ocultar un fallo en datos desconocidos.
Inicio rápido en el análisis
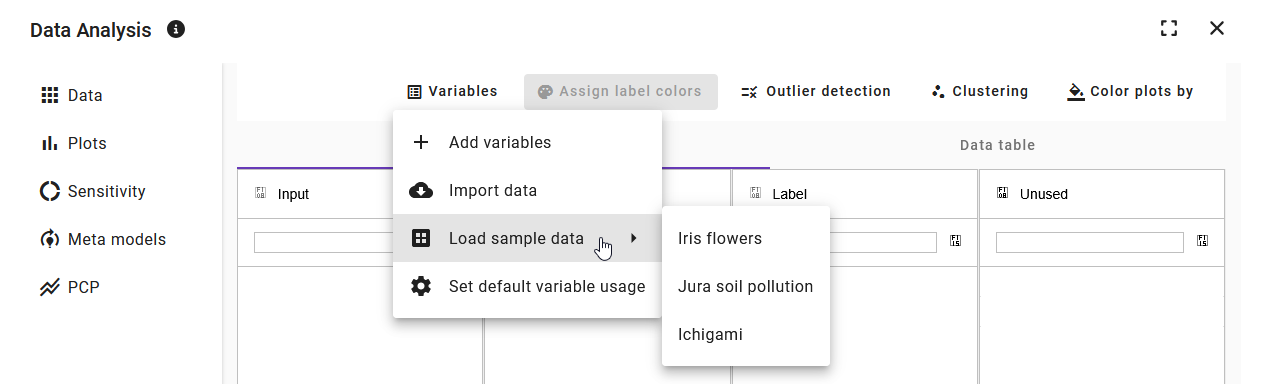
Para la primera impresión, hay tres conjuntos de datos de ejemplo disponibles: el clásico Iris para los primeros pasos con el clustering, un conjunto de datos sobre contaminación del suelo con varias variables de salida para metamodelos y un conjunto de datos sintético en el que las entradas y salidas ya están asignadas.
Otras novedades
Los archivos CSV se pueden abrir directamente desde el área de adjuntos de una prueba en el complemento.
Un conjunto de datos recién abierto comienza con una matriz de visión general compuesta por histogramas, gráficos de dispersión y correlaciones, así como un gráfico de dispersión 3D. Se añaden más gráficos según sea necesario.
La detección de valores atípicos ahora distingue entre “Reactivar todas las pruebas” y “Eliminar marcas de valores atípicos”.
La barra del panel se puede plegar en una barra de iconos estrecha para crear más espacio para el análisis.