返回

返回

搜索结果

      主页 / 产品更新 / SCALE.sdm 新功能 – 2026年8月至9月

      SCALE.sdm 新功能 – 2026年8月至9月

      8月和9月为模型中的日常工作带来多项改进,SCALE.sdm 的响应速度也更快;此外,Data Analysis 迎来重大更新,新增 GPU 训练和聚类分析。

      SCALE.sdm 仿真数据管理的核心解决方案 Add-on SCALE.sdm 的可选扩展

      SCALE.sdm 更新

      SCALE.sdm
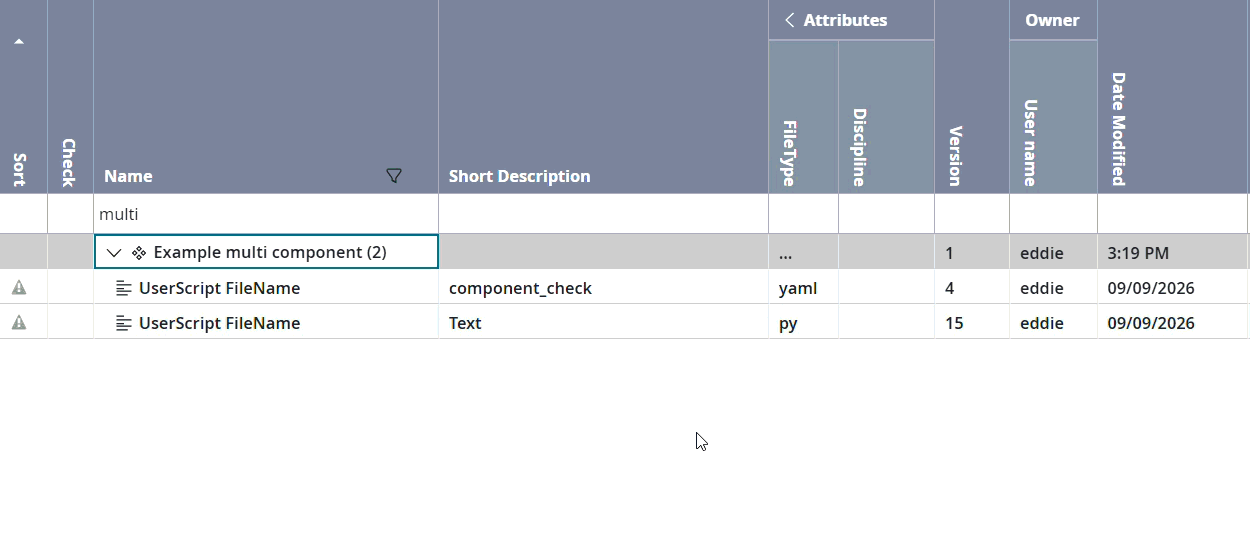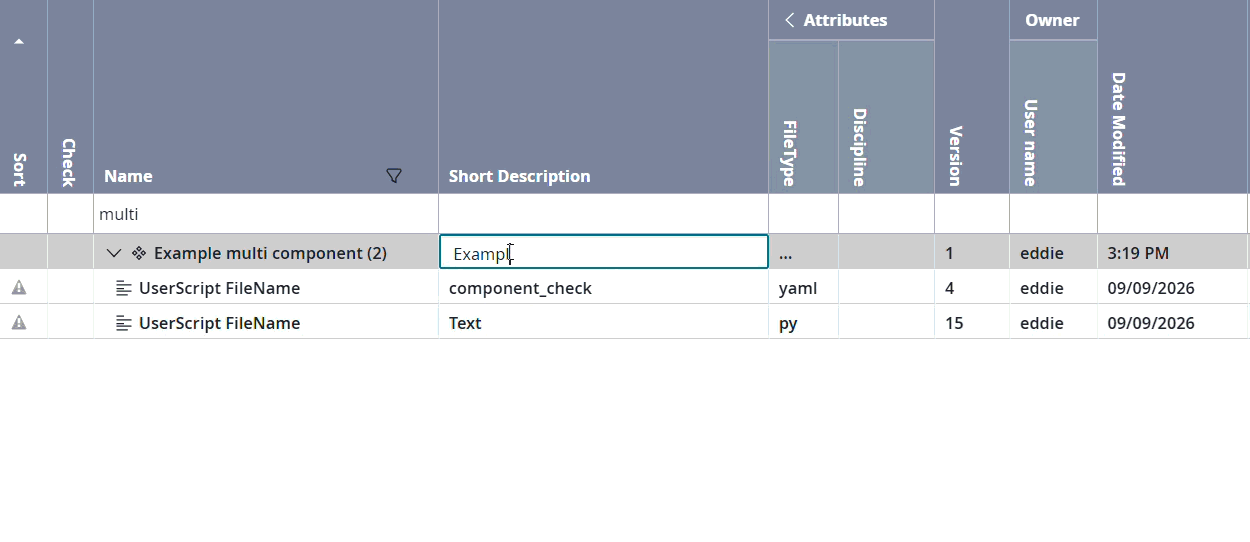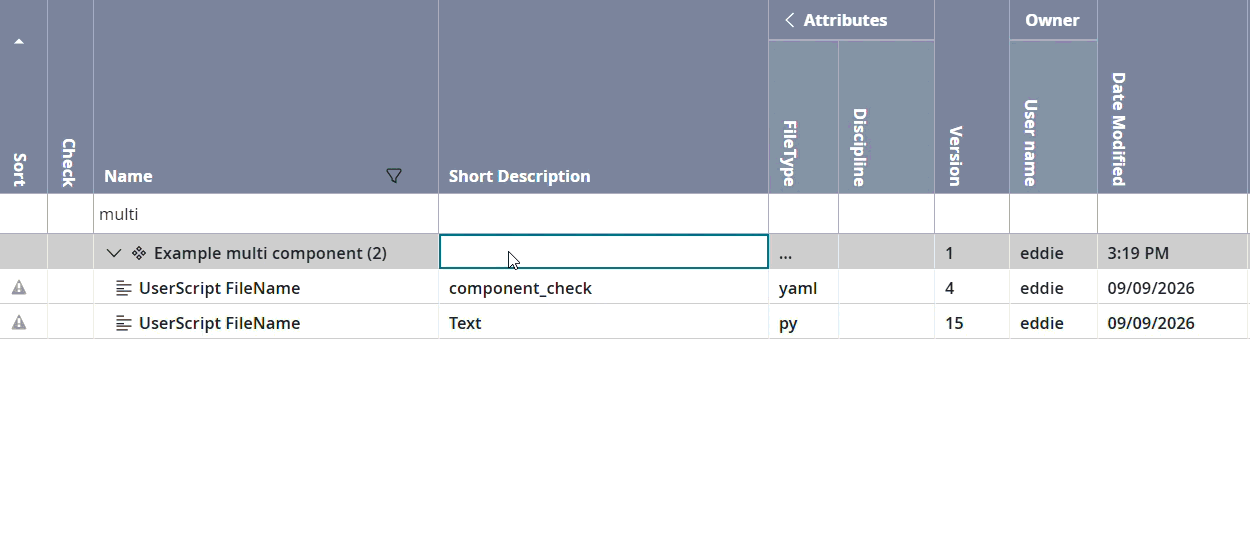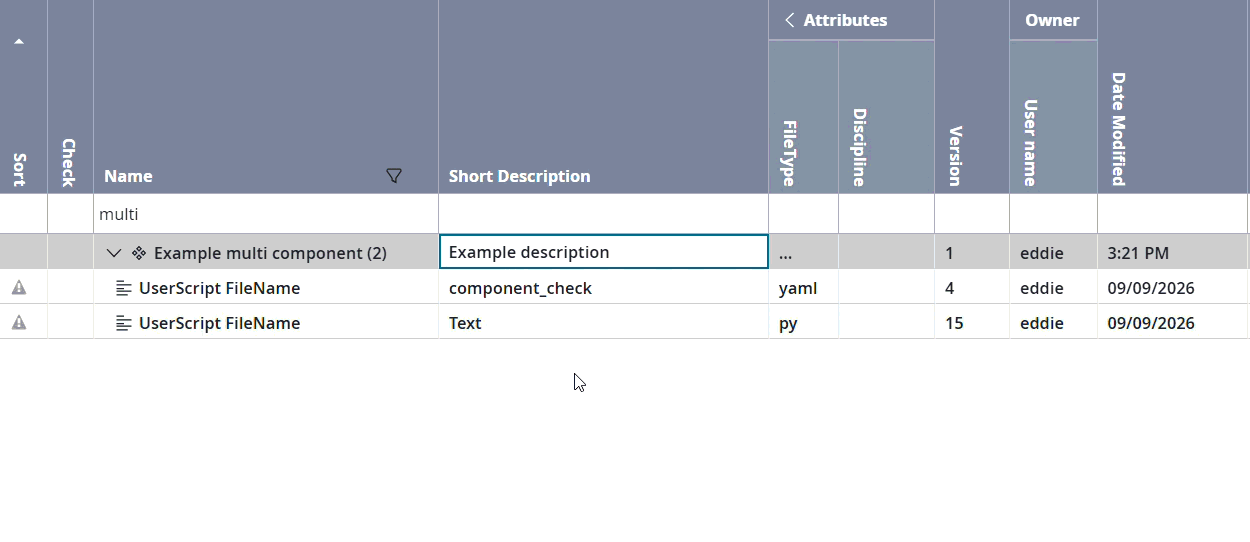
      在表格中编辑多组件的简短描述

      多组件的简短描述

      此前,多组件只能编辑名称。现在还可以添加简短描述:在表格中双击“简短描述”列,输入文本并按 Enter 确认。

      新增于:1.268 – SCALE.sdm | Model

      更顺畅的日常工作

      • 新建和复制的运行配置在创建后会立即被自动选中。
      • 对筛选、分组或列的更改现在只应用于当前标签页。只有在明确保存时,才会更新小组件预设。
      • 防护机制可防止在同一客户端的两个编辑标签页中打开同一个实时组件。
      • 分组视图新增“不排序”选项,与运行视图和池版本视图保持一致。
      • 现在可以打开不属于当前池版本的组件版本(例如在历史视图中选中的版本)的附件。
      • 在池内复制和粘贴运行配置时,会保留其历史记录。

      新增于:1.268 – 1.269 – SCALE.sdm | Model

      更快的响应,更安全的登录

      • 使用对象权限时权限检查更快,刷新权限缓存时的数据库查询更少。
      • 存储健康检查结果会被缓存,从而降低 S3 连接的负载。
      • 保存文件时,现在只为该文件启动一个复制任务,而不是为整个表启动。
      • 可在运行设置中配置 OpenID Connect 的 scope。
      • 启用许可证检查时,已锁定的主数据仍受保护。
      • 应用程序镜像的安全更新。

      新增于:2.2.5 – 2.2.9 – SCALE.sdm | Project + Result
      附加组件和工具更新

      Add-on

      Data Analysis

      将数据转化为可执行的洞察。

      Add-on
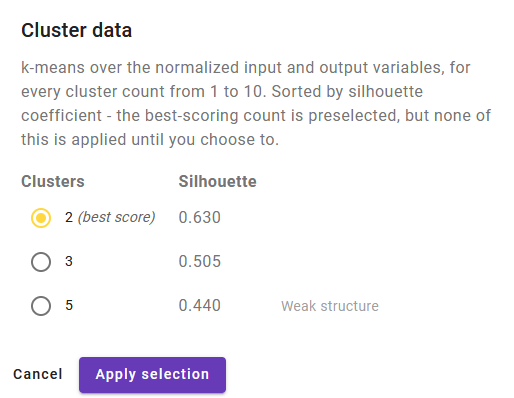
      显示各聚类数轮廓系数的聚类分析对话框

      通过聚类分析发现结构

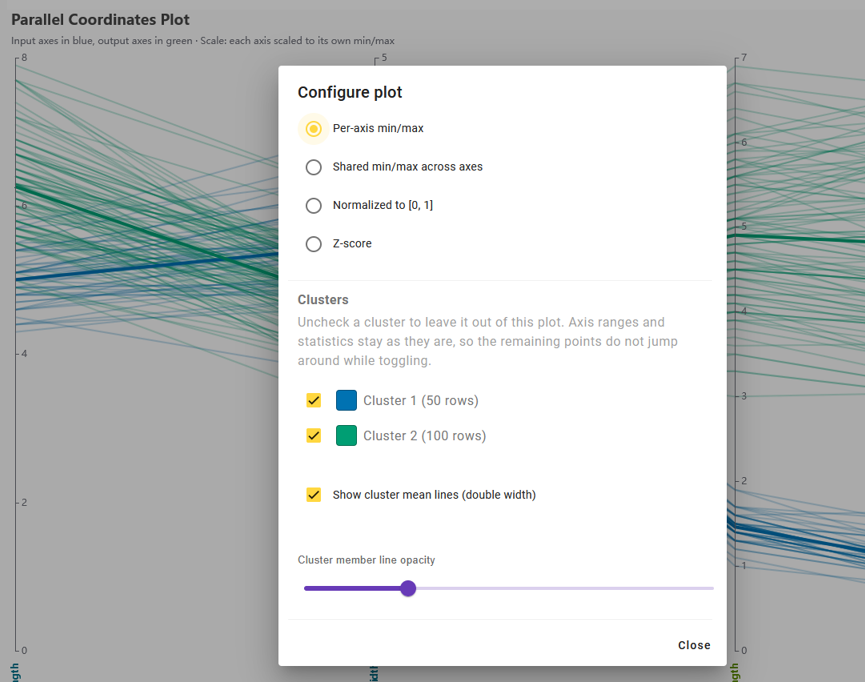
      新的 k-means 聚类分析会评估 1 到 10 的每种聚类数,并将最佳结果排在首位,同时给出清晰的质量提示。应用后,只需一项设置即可按聚类为所有图表着色,平行坐标图还会显示每个聚类的平均值。

      新增于:3.0 – Data Analysis

      带有输入轴和输出轴的平行坐标图

      更清晰地查看数据

      平行坐标图现在将输入与输出分开显示,提供多种坐标轴缩放方式,并且无需元模型即可使用。概览矩阵将直方图、散点图和相关性集中在一个视图中。

      借助示例数据集可以立即开始分析,CSV 文件可直接从试验的附件中打开。

      新增于:3.0 – Data Analysis

      在 GPU 上训练的更优元模型

      在浏览器支持时,训练会使用显卡,否则自动切换到处理器。新的默认设置结合早停机制,以相当或更短的运行时间获得更好的模型。

      新增于:3.0 – Data Analysis

      值得信赖的模型质量

      • 神经网络在后台与线性模型同时训练,让您看清响应是否真的是非线性的。
      • 彩色评级综合了每个模型的训练分数和测试分数。
      • 如果新训练模型的测试分数为负,或明显低于当前活动模型,则不会将其设为活动模型。

      新增于:2.2 – 3.0 – Data Analysis