菜单
返回
发布于 2026年10月9日
SCALE.sdm扩展插件Data Analysis帮助可视化试验数据中的趋势,发现异常值并构建元模型。3.0版本带来了众多新功能:自动聚类分析、显卡加速训练、显著扩展的平行坐标图以及更快捷的分析入门体验。
借助3.0版本,Data Analysis成为一个更强大的工具,使用户能够在SCALE.sdm中快速从仿真和试验数据中获得可靠见解。
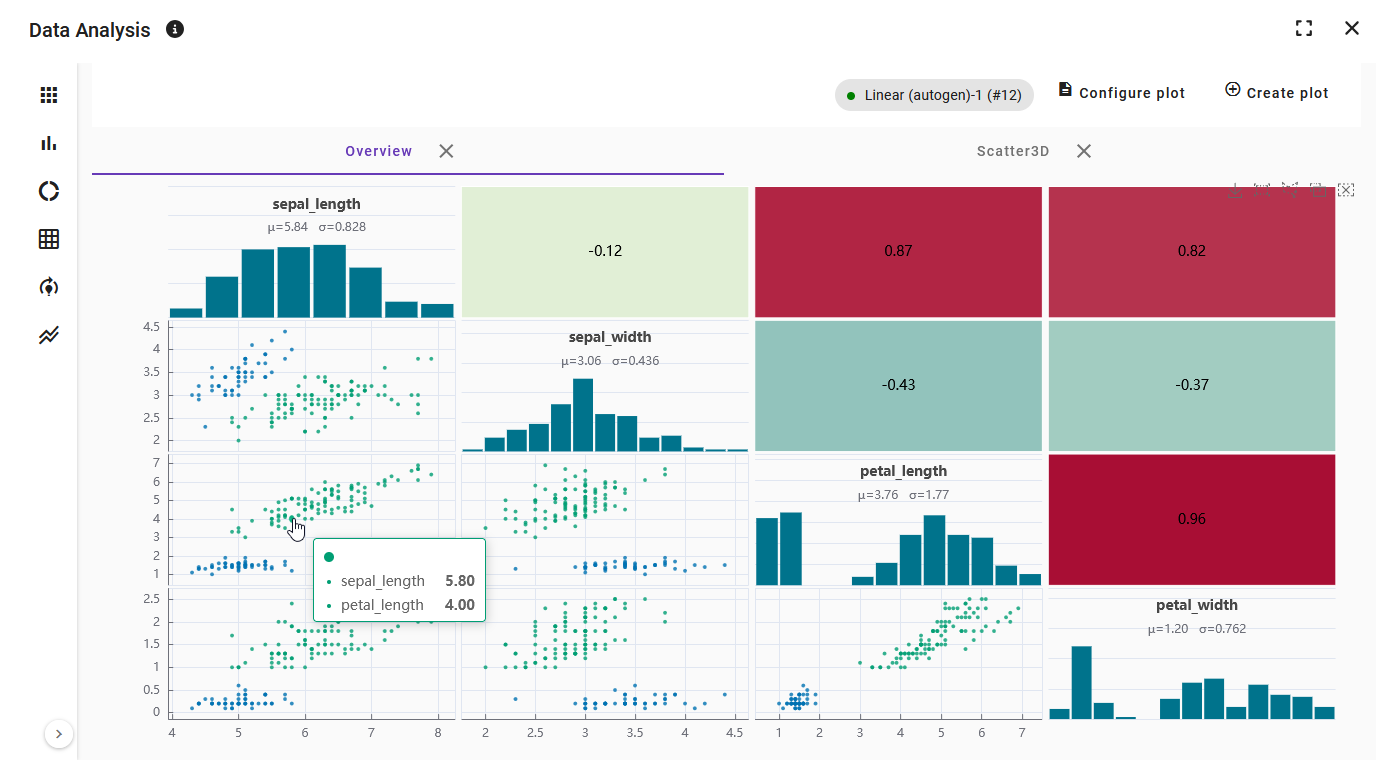
新的聚类分析将输入和输出参数相似的试验归为一组,从而发现单个图表中无法察觉的数据模式。
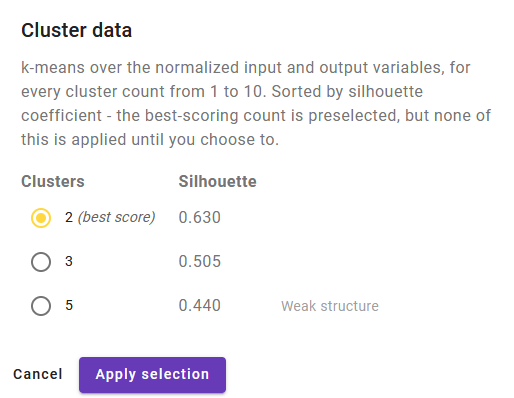
该扩展插件使用k均值算法,并确定最优聚类数目。结果还会被进行额外评价。
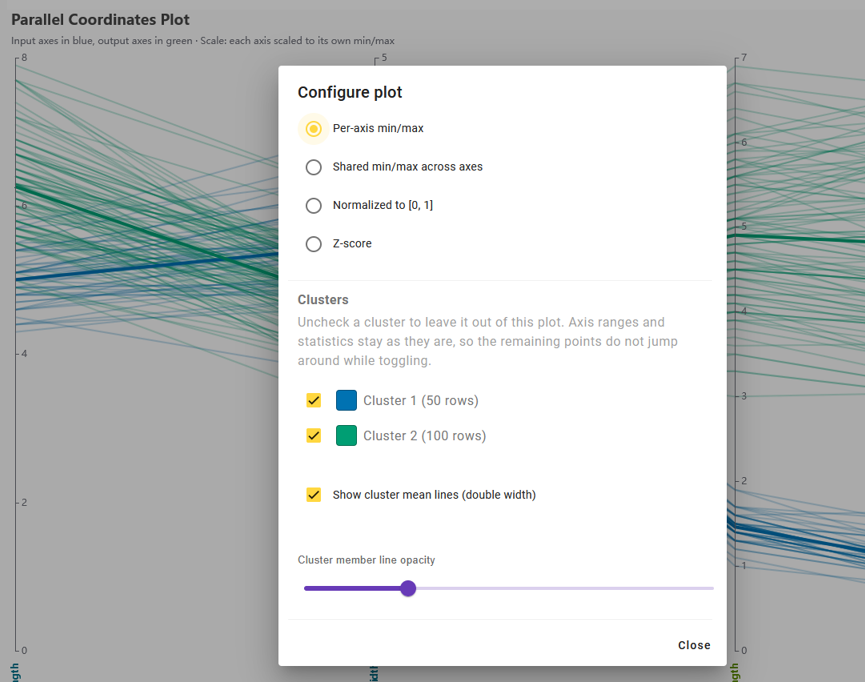
应用后,每个试验在数据表中会有一列表示聚类。每个聚类都会分配一种可调整的颜色,可在所有图表或特定图表中单独显示或隐藏。
现在通过一个设置即可统一所有图表的着色方式:按异常值状态、标签或聚类。如此所有展示一目了然且一致。该新设置取代了之前需要在每个图表中单独设定的方式。
平行坐标图现在直接从设定为输入或输出的变量中获取其轴线。
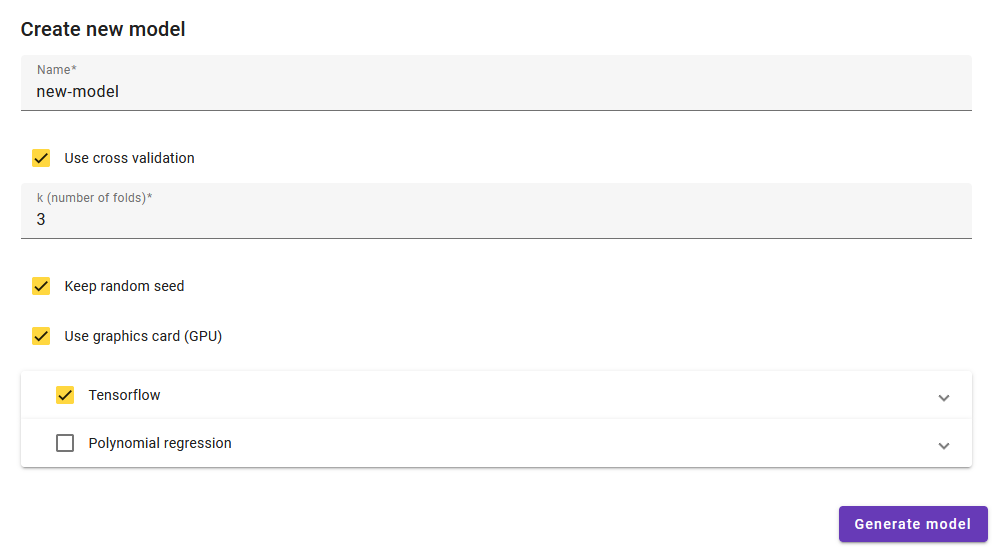
神经网络元模型现在支持在图形处理器(GPU)上训练,前提是浏览器支持此功能。该选项默认开启,并会保存至下一次会话。无需任何设置:如果没有可用的GPU,训练将自动在处理器(CPU)上继续。两种情况下模型保持完全一致,仅训练时间不同。
神经网络的默认设置也已调整为适配插件中的典型数据集。训练最多进行800个周期,但会在模型不再提升时提前停止。
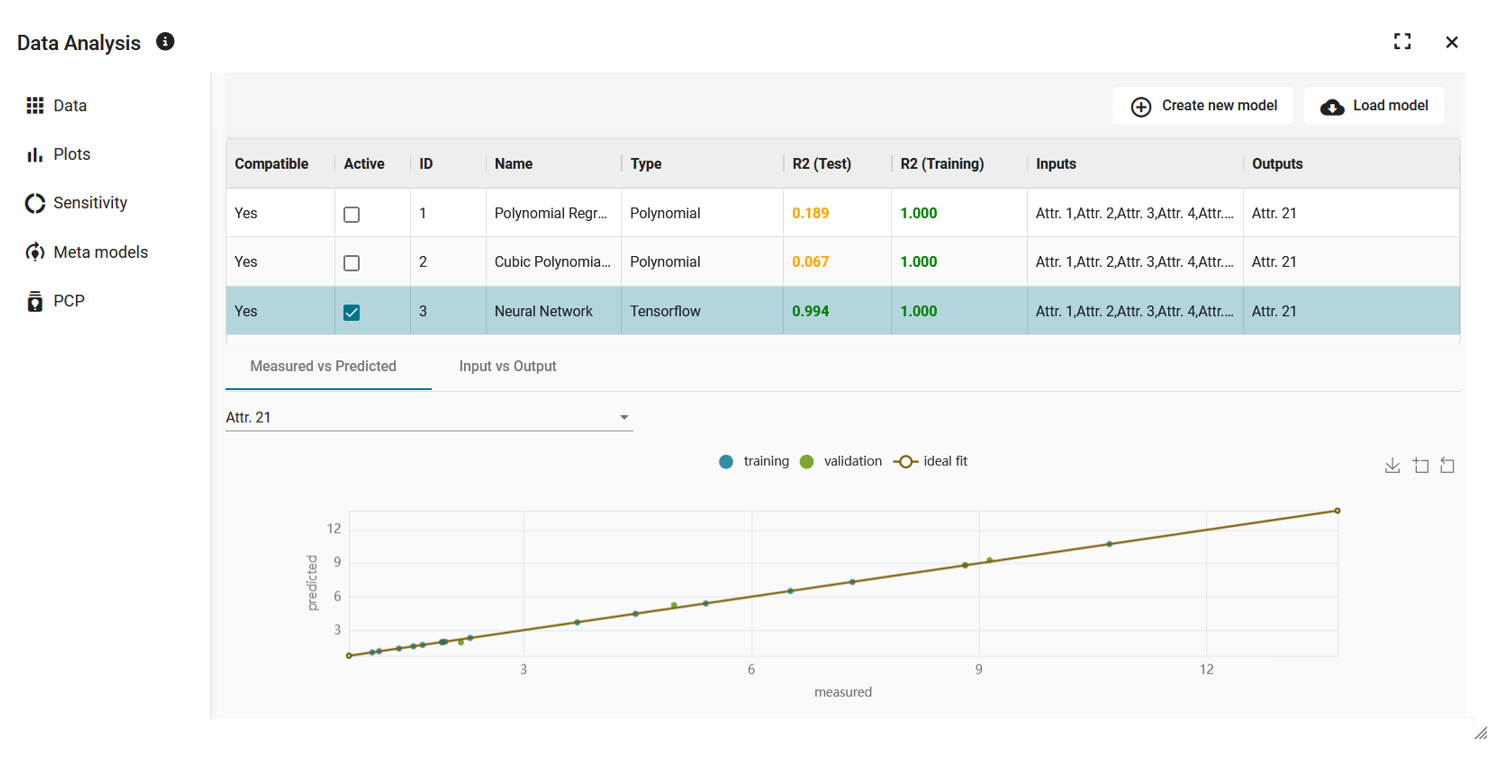
每个模型将获得一个颜色评分,综合反映测试和训练的表现。评分会显示在模型列表以及绘图和敏感性分析的模型选择中。如果模型在测试或训练数据上的表现比简单的均值预测还差,则评分始终为红色。良好的训练评分无法掩盖模型在未知数据上的缺陷。
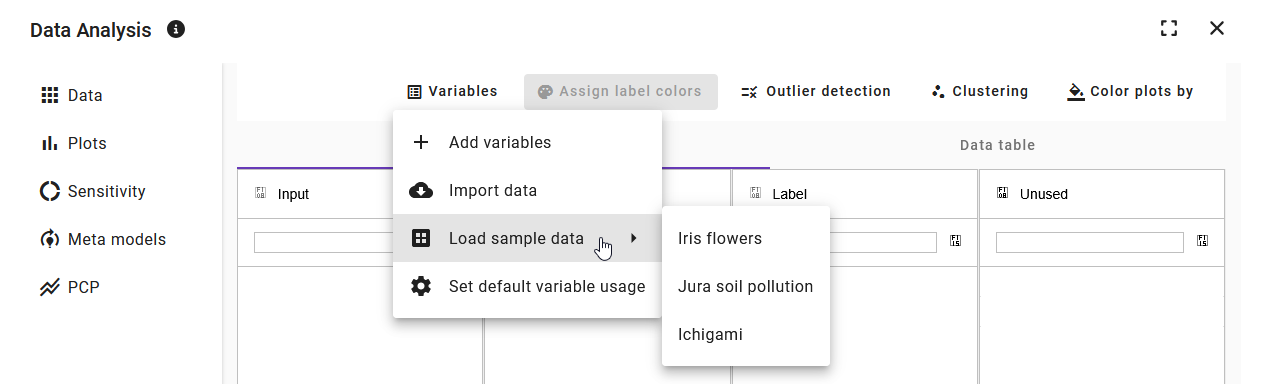
为了初步印象,提供了三个示例数据集:经典的鸢尾花数据集用于聚类的入门,一个包含多个元模型输入变量的土壤负载数据集,以及一个输入和输出已对应的合成数据集。
我们希望更详细地了解您和您的项目。请使用我司的联系表单,或直接与负责人联系。