Zurück

Suchergebnisse

      Startseite / Produkt-Updates / Neu in SCALE.sdm – August – September 2026

      Neu in SCALE.sdm – August – September 2026

      August und September bringen viele Verbesserungen für die tägliche Arbeit im Modell und schnellere Antwortzeiten in SCALE.sdm – dazu ein großes Update von Data Analysis mit GPU-Training und Clusteranalyse.

      SCALE.sdm Die Kernlösung für das Simulationsdatenmanagement Add-on Optionale Erweiterungen für SCALE.sdm

      Neuerungen in SCALE.sdm

      SCALE.sdm
      Kurzbeschreibung einer Multikomponente im Grid bearbeiten

      Kurzbeschreibungen für Multikomponenten

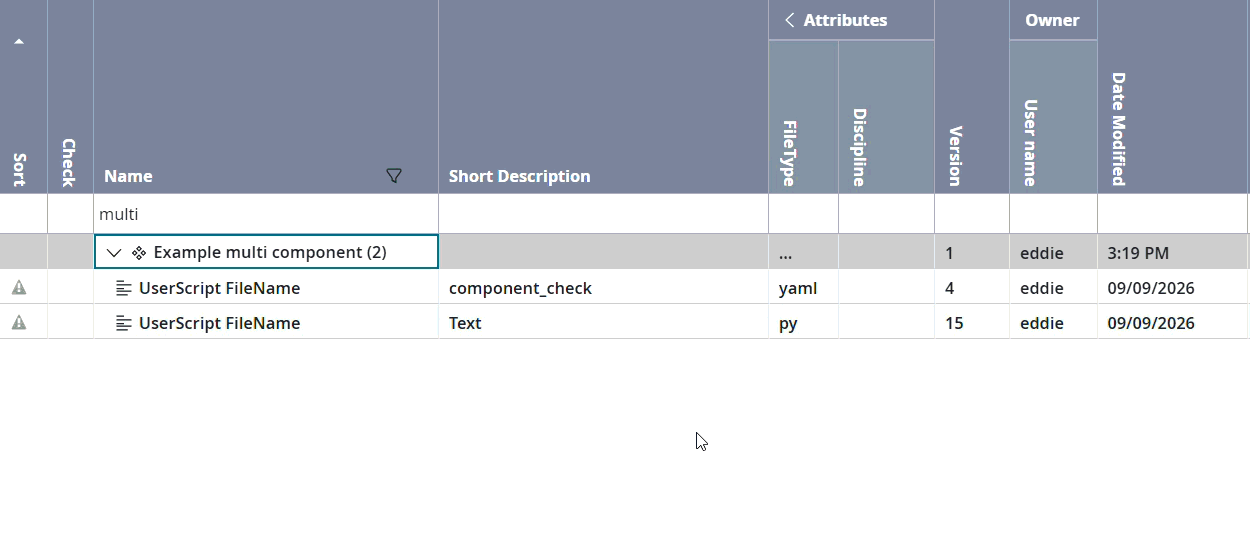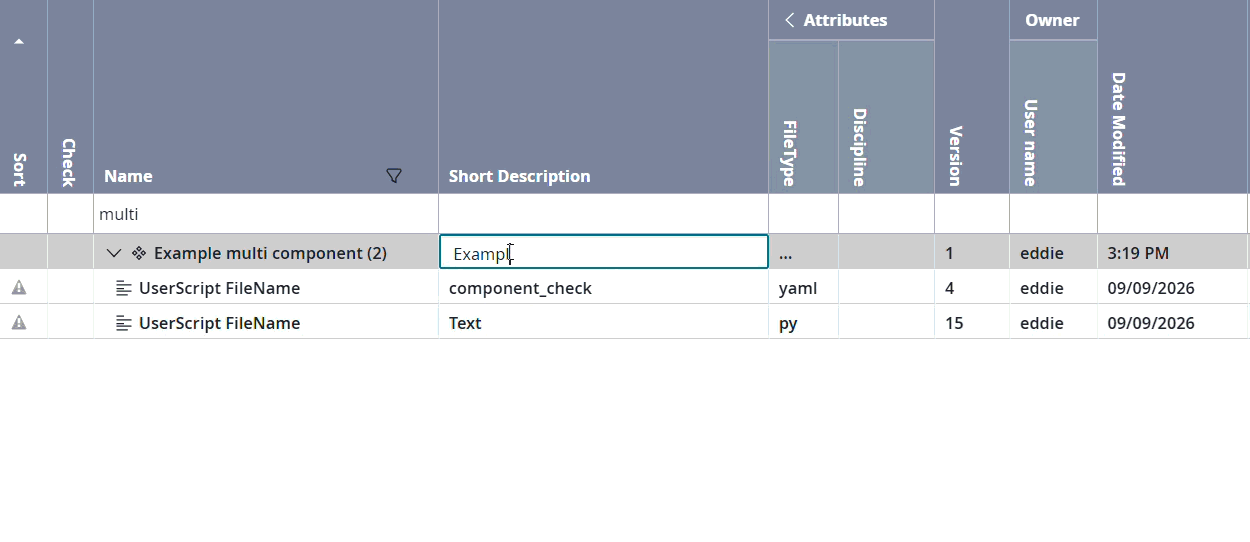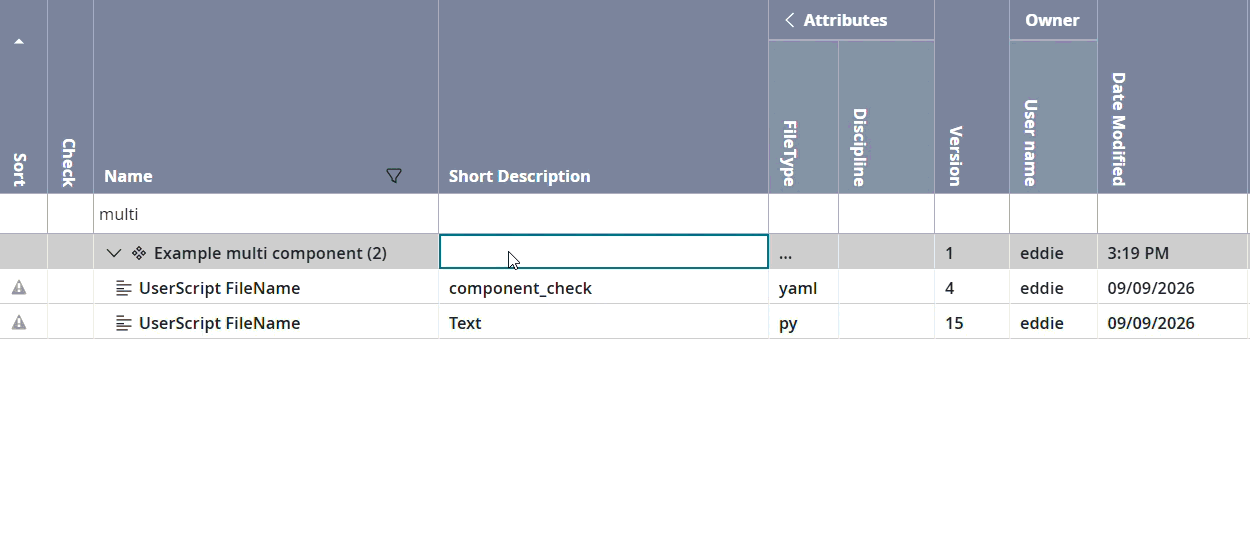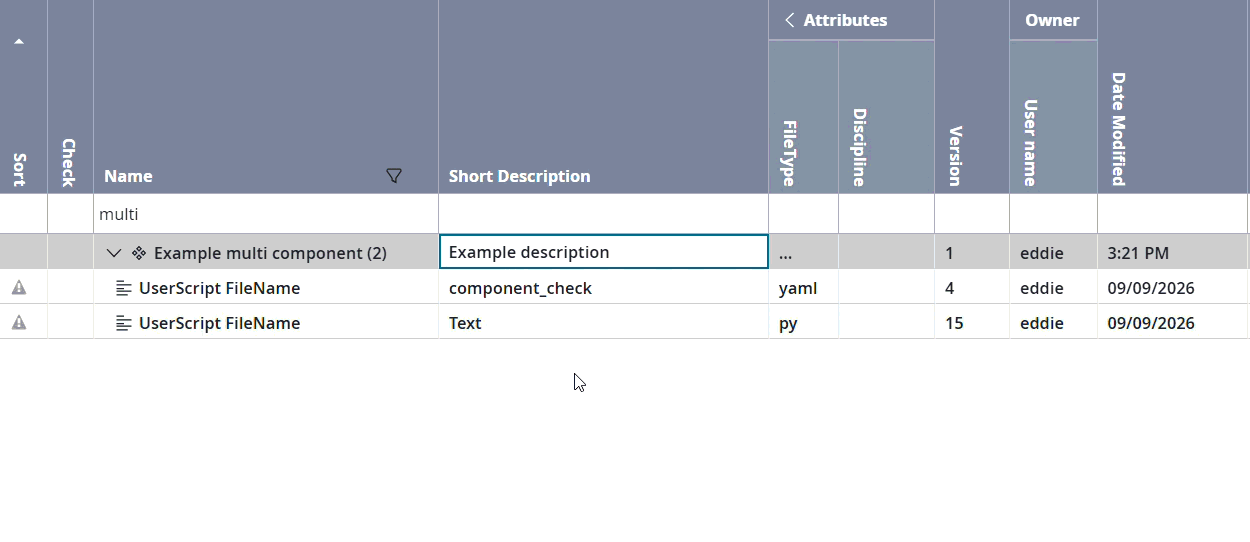
      Bisher ließ sich bei einer Multikomponente nur der Name bearbeiten. Jetzt können Sie auch eine Kurzbeschreibung hinterlegen: Doppelklick in die Spalte Kurzbeschreibung im Grid, Text eingeben und mit Enter bestätigen.

      Neu in: 1.268 – SCALE.sdm | Model
      Reibungsloser arbeiten

      • Neue und duplizierte Run-Konfigurationen werden direkt nach dem Anlegen automatisch ausgewählt.
      • Änderungen an Filtern, Gruppierung oder Spalten gelten jetzt nur für den aktuellen Tab. Ein Widget-Preset wird nur aktualisiert, wenn Sie es ausdrücklich speichern.
      • Eine Sperre verhindert, dass dieselbe Live-Komponente in einem Client in zwei Bearbeitungs-Tabs geöffnet wird.
      • Die Gruppenansicht bietet die Option „unsortiert“, wie schon die Ansichten Runs und Pool-Versionen.
      • Anhänge einer Komponentenversion, die nicht zur aktuellen Pool-Version gehört, etwa einer in der Historie ausgewählten, lassen sich jetzt öffnen.
      • Beim Kopieren und Einfügen einer Run-Konfiguration innerhalb eines Pools bleibt ihre Historie erhalten.

      Neu in: 1.268 – 1.269 – SCALE.sdm | Model

      Schnellere Antworten, sichere Anmeldung

      • Schnellere Rechteprüfungen bei Objektrechten und weniger Datenbankabfragen, wenn der Rechte-Cache aktualisiert wird.
      • Die Statusprüfungen des Speichers werden zwischengespeichert. Das entlastet die S3-Verbindungen.
      • Beim Speichern einer Datei startet jetzt ein Kopierauftrag nur für diese Datei statt für die ganze Tabelle.
      • Der OpenID-Connect-Scope lässt sich in den Betriebseinstellungen konfigurieren.
      • Gesperrte Stammdaten bleiben geschützt, wenn Lizenzprüfungen aktiv sind.
      • Sicherheitsupdates der Anwendungs-Images.

      Neu in: 2.2.5 – 2.2.9 – SCALE.sdm | Project + Result

      Neuerungen in Add-ons und Tools

      Add-on

      Data Analysis

      Machen Sie aus Ihren Daten verwertbare Erkenntnisse.

      Add-on
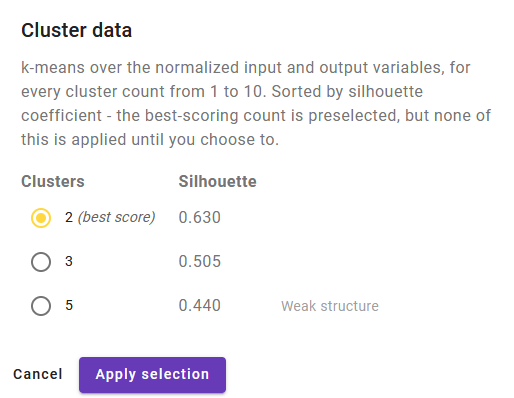
      Dialog der Clusteranalyse mit Silhouette-Werten je Clusteranzahl

      Strukturen finden mit Clusteranalyse

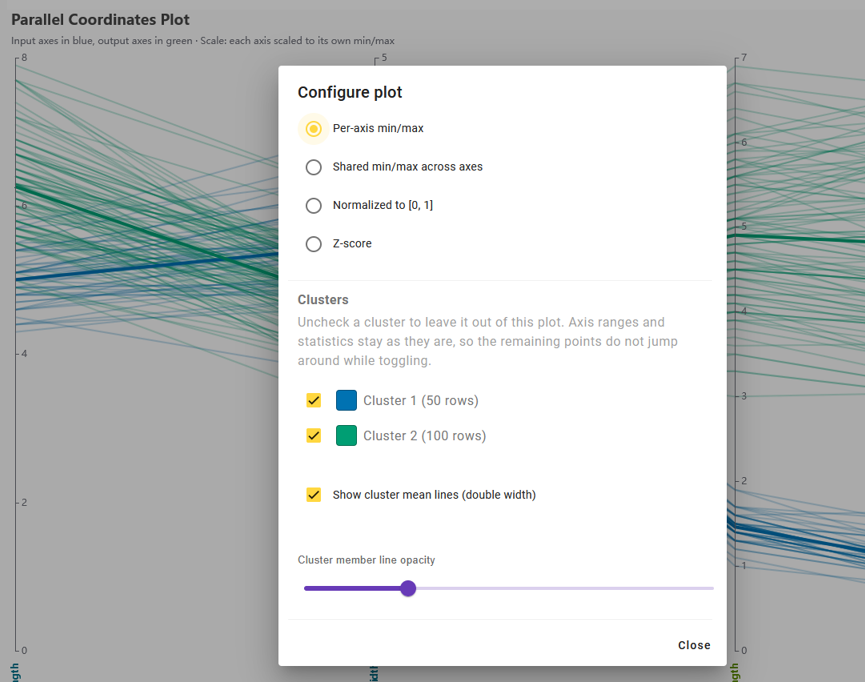
      Die neue k-Means-Clusteranalyse bewertet jede Clusteranzahl von 1 bis 10 und zeigt die beste zuerst an, mit einem klaren Hinweis zur Qualität. Nach dem Übernehmen färbt eine Einstellung alle Plots nach Cluster, und der Parallele-Koordinaten-Plot zeigt den Mittelwert jedes Clusters.

      Neu in: 3.0 – Data Analysis

      Parallele-Koordinaten-Plot mit Eingangs- und Ausgangsachsen

      Klarerer Blick auf Ihre Daten

      Der Parallele-Koordinaten-Plot trennt jetzt Eingangs- von Ausgangsgrößen, bietet mehrere Achsenskalierungen und funktioniert auch ohne Metamodell. Die Übersichtsmatrix vereint Histogramme, Streudiagramme und Korrelationen in einer Ansicht.

      Mit Beispieldatensätzen können Sie sofort loslegen, und CSV-Dateien öffnen sich direkt aus den Anhängen eines Versuchs.

      Neu in: 3.0 – Data Analysis

      Bessere Metamodelle, trainiert auf der GPU

      Das Training nutzt die Grafikkarte, wo der Browser es unterstützt, und weicht sonst automatisch auf den Prozessor aus. Neue Standardeinstellungen mit Early Stopping liefern bessere Modelle bei vergleichbarer oder kürzerer Laufzeit.

      Neu in: 3.0 – Data Analysis

      Modellqualität, auf die Sie sich verlassen können

      • Neben dem linearen Modell trainiert im Hintergrund ein neuronales Netz. So sehen Sie, ob die Antwort wirklich nichtlinear ist.
      • Eine farbige Bewertung fasst Trainings- und Testwerte für jedes Modell zusammen.
      • Ein neu trainiertes Modell wird nicht aktiv geschaltet, wenn sein Testwert negativ ist oder deutlich unter dem des aktiven Modells liegt.

      Neu in: 2.2 – 3.0 – Data Analysis