Zurück

Suchergebnisse

      Startseite / News / Data Analysis 3.0: Cluster erkennen, schneller trainieren, Zusammenhänge klarer sehen

      Data Analysis 3.0: Cluster erkennen, schneller trainieren, Zusammenhänge klarer sehen

      Das SCALE.sdm-Add-on Data Analysis hilft dabei, Trends in Versuchsdaten zu visualisieren, Ausreißer aufzuspüren und Metamodelle zu erstellen. Mit Version 3.0 kommen zahlreiche Neuerungen hinzu: eine automatische Clusteranalyse, Training auf der Grafikkarte, ein deutlich erweiterter Parallel Coordinates Plot und ein schnellerer Einstieg in die Analyse.

      Mit Version 3.0 wird Data Analysis zu einem noch stärkeren Werkzeug, um aus Simulations- und Versuchsdaten schnell belastbare Erkenntnisse zu gewinnen, direkt in SCALE.sdm.

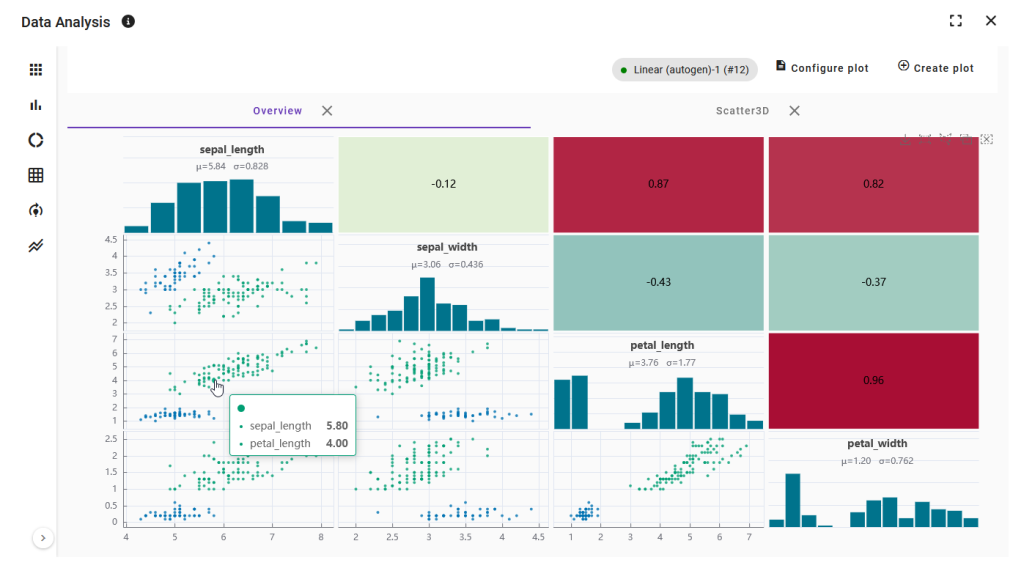
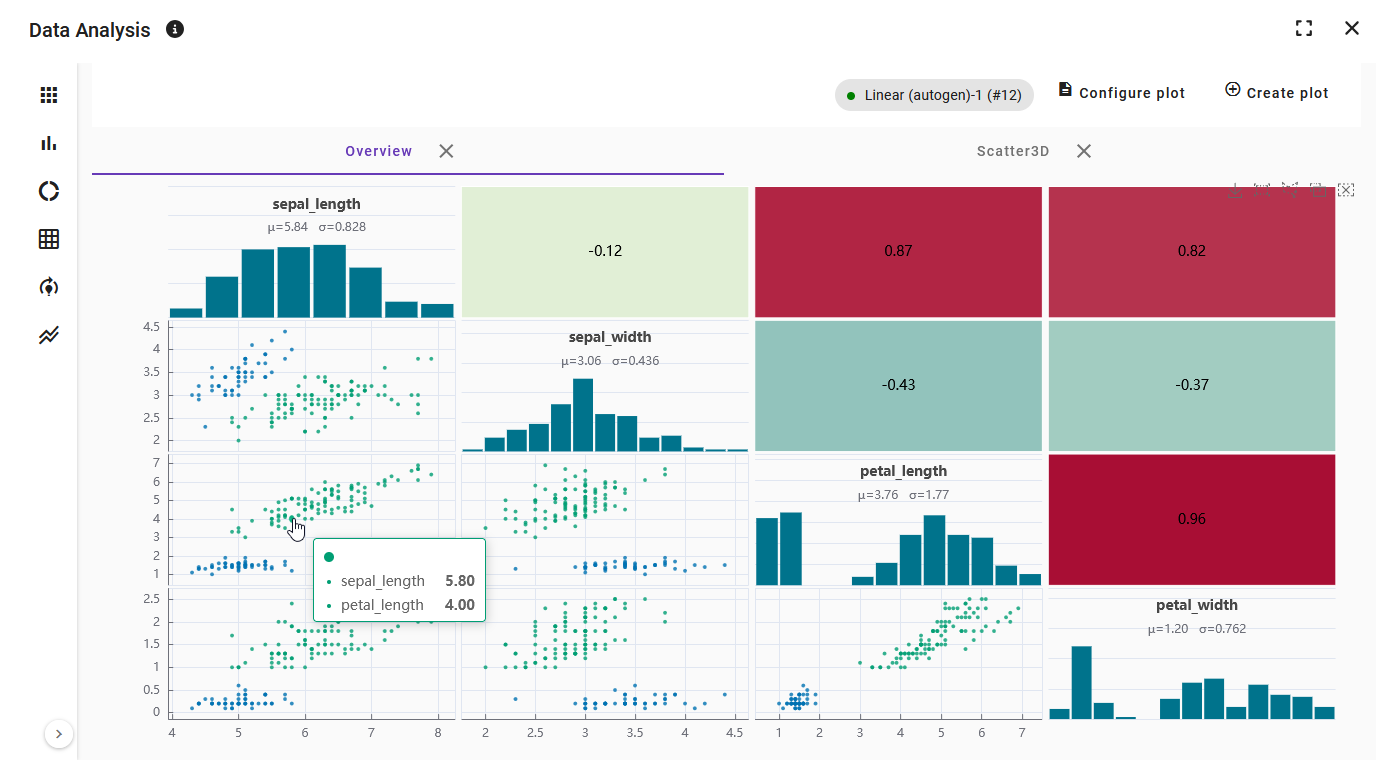
      Übersichtsmatrix mit Histogrammen, Streudiagrammen und Korrelationen
      Die Übersichtsmatrix kombiniert Histogramme, Streudiagramme und Korrelationen.
      Ähnliche Tests automatisch gruppieren

      Die neue Clusteranalyse fasst Tests mit ähnlichen Eingangs- und Ausgangsgrößen zu Gruppen zusammen. So lassen sich Muster in den Daten entdecken, die in einem einzelnen Plot nicht sichtbar sind.

      Das Add-on nutzt dafür den k-Means-Algorithmus und die optimale Clusteranzahl wird ermittelt. Die Ergebnisse werden zusätzlich noch bewertet.

      Nach dem Übernehmen erhält jeder Test eine Cluster-Spalte in der Datentabelle. Jeder Cluster bekommt eine eigene Farbe, die sich anpassen lässt, und kann in allen Plots oder gezielt in einzelnen Plots ein- und ausgeblendet werden.

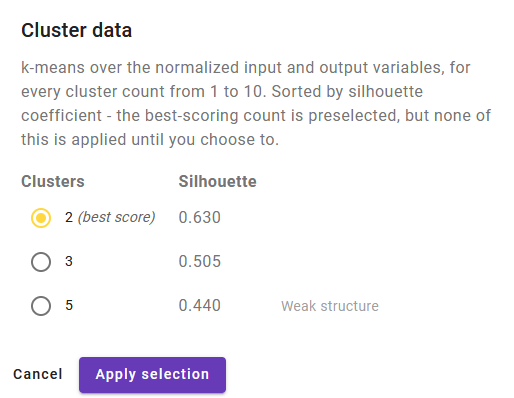
      Dialog „Cluster data“ mit Silhouetten-Score je Clusteranzahl
      Jede Clusteranzahl wird bewertet, die beste ist vorausgewählt.
      Einheitlich einfärben mit „Color plots by“

      Eine einzige Einstellung legt jetzt fest, wie alle Plots eingefärbt werden: nach Ausreißer-Status, nach Label oder nach Cluster. Damit sind alle Darstellungen auf einen Blick konsistent. Die neue Einstellung ersetzt die bisherige Auswahl, die in jedem Plot einzeln gesetzt werden musste.

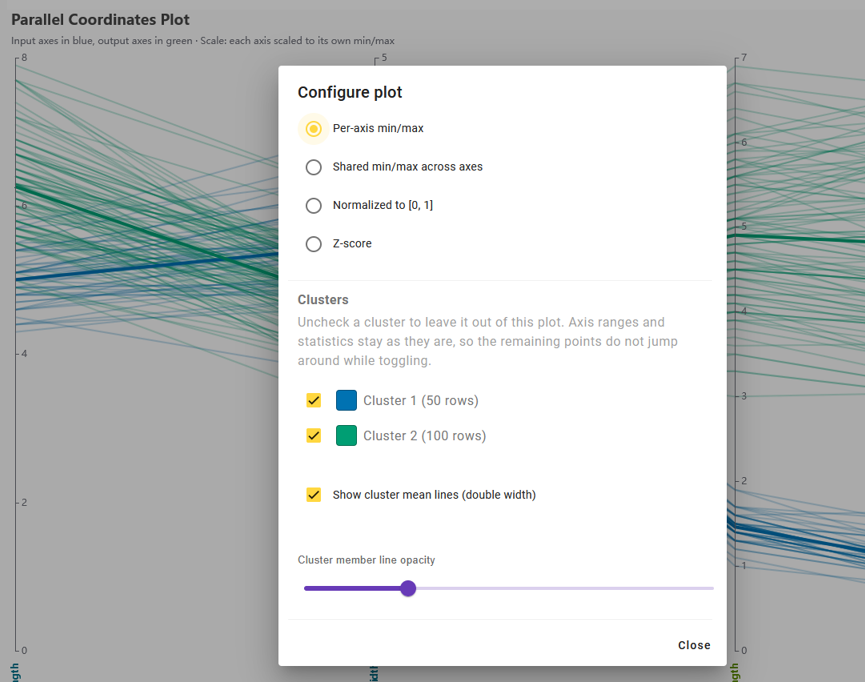
      Konfiguration des Parallel Coordinates Plot mit Clustern, Mittelwertlinien und Transparenz
      Achsenskalierung, Cluster-Auswahl, Mittelwertlinien und Transparenz in einem Dialog.
      Parallel Coordinates Plot: Zusammenhänge auf einen Blick

      Der Parallel Coordinates Plot übernimmt seine Achsen jetzt direkt aus den Variablen, die als Eingang oder Ausgang festgelegt sind.

      • Vier Achsenskalierungen: je Achse, gemeinsamer Wertebereich, normiert auf [0, 1] oder als z-Score.
      • Bei geclusterten Daten zeigt der Plot den Mittelwert jedes Clusters als hervorgehobene Linie.
      • Die einzelnen Linien werden abgeblendet, damit die Mittelwerte im Vordergrund stehen. Die Transparenz lässt sich per Schieberegler anpassen.

      Schneller zum Metamodell: Training auf der GPU

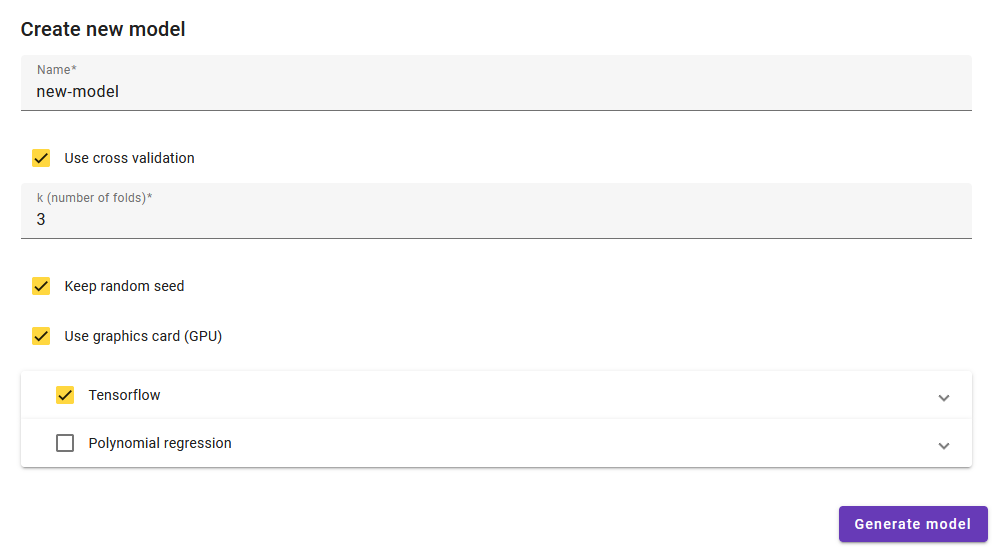
      Metamodelle mit neuronalen Netzen werden jetzt auf der Grafikkarte (GPU) trainiert, sofern der Browser dies unterstützt. Die Option ist standardmäßig aktiv und wird für die nächste Sitzung gespeichert. Eine Einrichtung ist nicht nötig: Steht keine Grafikkarte zur Verfügung, läuft das Training automatisch auf dem Prozessor weiter. Das Modell ist in beiden Fällen identisch, nur die Trainingsdauer unterscheidet sich.

      Auch die Standardeinstellungen für neuronale Netze wurden auf die typischen Datensätze im Add-on abgestimmt. Ein Training läuft jetzt bis zu 800 Epochen, stoppt aber, sobald sich das Modell nicht mehr verbessert.

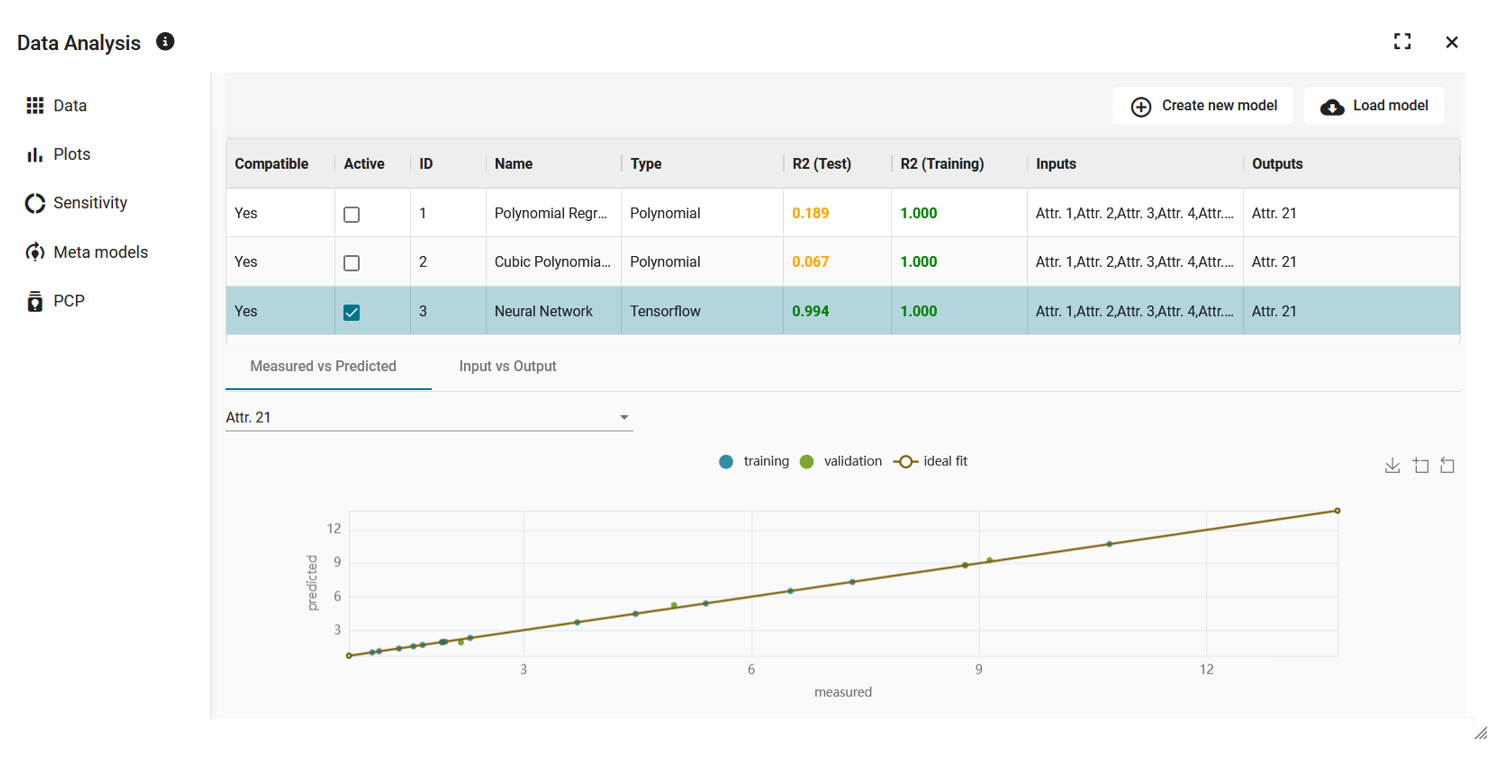
      Modellqualität auf einen Blick

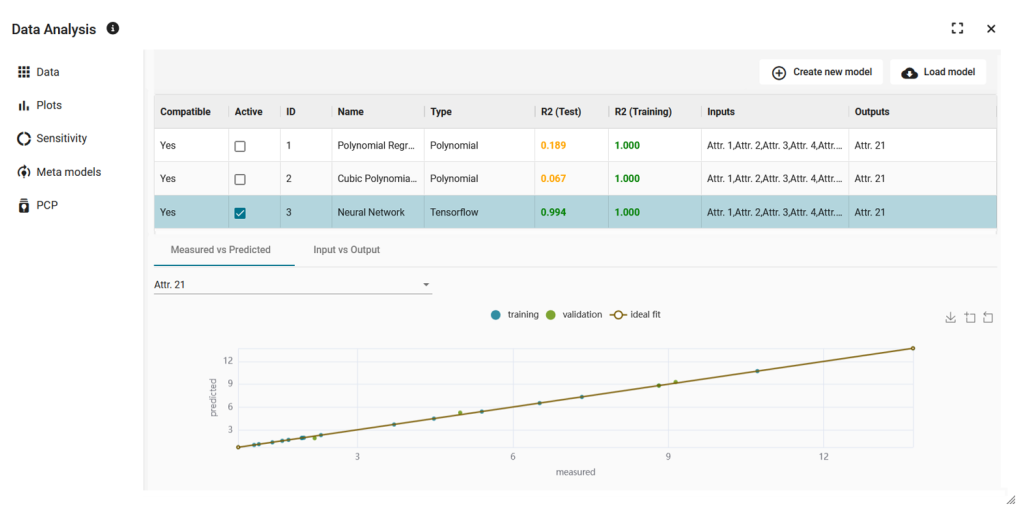
      Jedes Modell erhält eine farbige Bewertung, die die Werte für Test und Training zusammenfasst. Sie erscheint in der Modellliste und in der Modellauswahl der Plots und der Sensitivitätsanalyse. Schneidet ein Modell auf Test- oder Trainingsdaten schlechter ab als die reine Vorhersage des Mittelwerts, ist die Bewertung immer rot. Ein guter Trainingswert kann ein Versagen auf unbekannten Daten so nicht überdecken.

      Schneller Einstieg in die Analyse

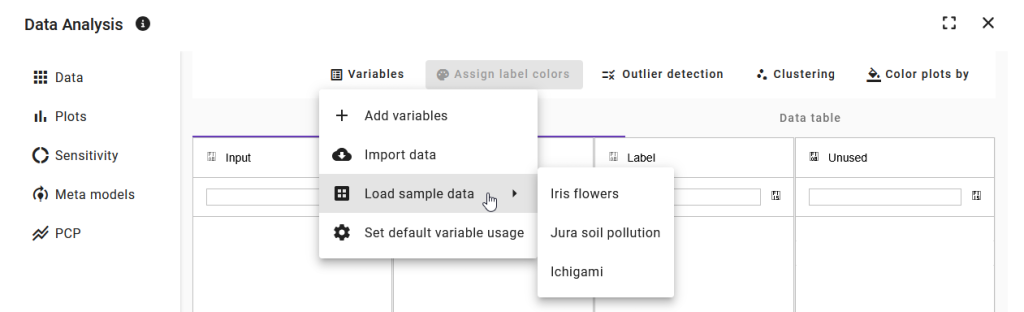
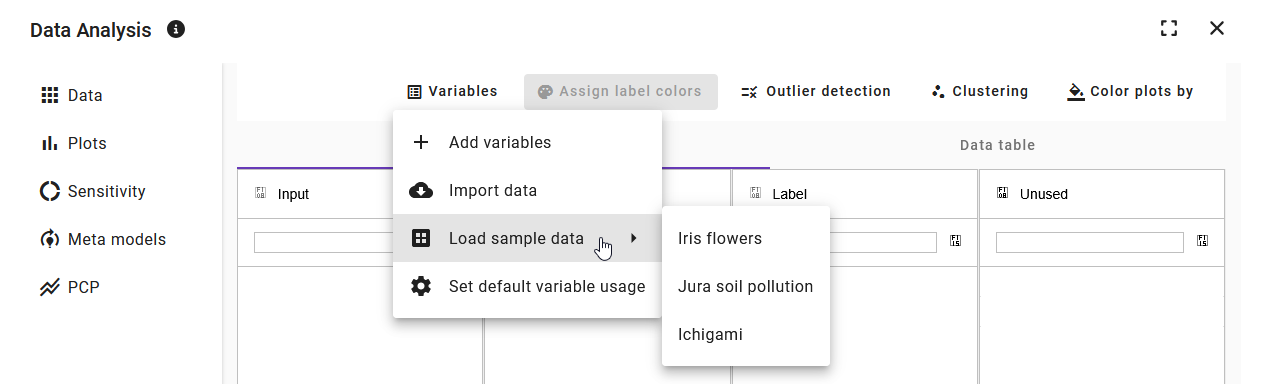
      Für den ersten Eindruck stehen drei Beispieldatensätze bereit: der Klassiker Iris für erste Schritte mit dem Clustering, ein Datensatz zur Bodenbelastung mit mehreren Ausgangsgrößen für Metamodelle und ein synthetischer Datensatz, bei dem Ein- und Ausgänge bereits zugeordnet sind.

      Weitere Neuerungen

      • CSV-Dateien lassen sich direkt aus dem Anhangsbereich eines Tests im Add-on öffnen.
      • Ein neu geöffneter Datensatz startet mit einer Übersichtsmatrix aus Histogrammen, Streudiagrammen und Korrelationen sowie einem 3D-Streudiagramm. Weitere Plots kommen bei Bedarf hinzu.
      • Die Ausreißererkennung unterscheidet jetzt zwischen „Alle Tests reaktivieren“ und „Ausreißer-Markierungen entfernen“.
      • Die Panel-Leiste lässt sich auf eine schmale Symbolleiste einklappen, um mehr Platz für die Analyse zu schaffen.